OpenAIの敵対的蒸留対策とは?4層の防御と開発者への影響【2026年11月】
目次
2026年11月20日に OpenAI が発表した「Combatting adversarial distillation」は、自社モデルの能力を外から抜き取る行為への対抗方針を示した文書だ。モデルの訓練、セーフガード、検知、執行の4つを重ねて守るという。新機能や料金の発表ではない。ただし API を大量に呼ぶ企業や、合成データで自社モデルを育てる開発者には、規約と運用を見直すきっかけになる。本記事では発表の中身と、編集部の評価を分けて伝える。
この記事のポイント
- OpenAI が敵対的蒸留への対策方針を11月20日に公表
- 訓練・セーフガード・検知・執行の4層で能力抽出を防ぐ
- 料金や新機能の発表ではなく、防御方針の説明である
- 編集部は、大量の自動呼び出しへの監視が強まると見る
- 正規の蒸留機能と規約の範囲を確かめるのが先だと考える
何が発表されたか
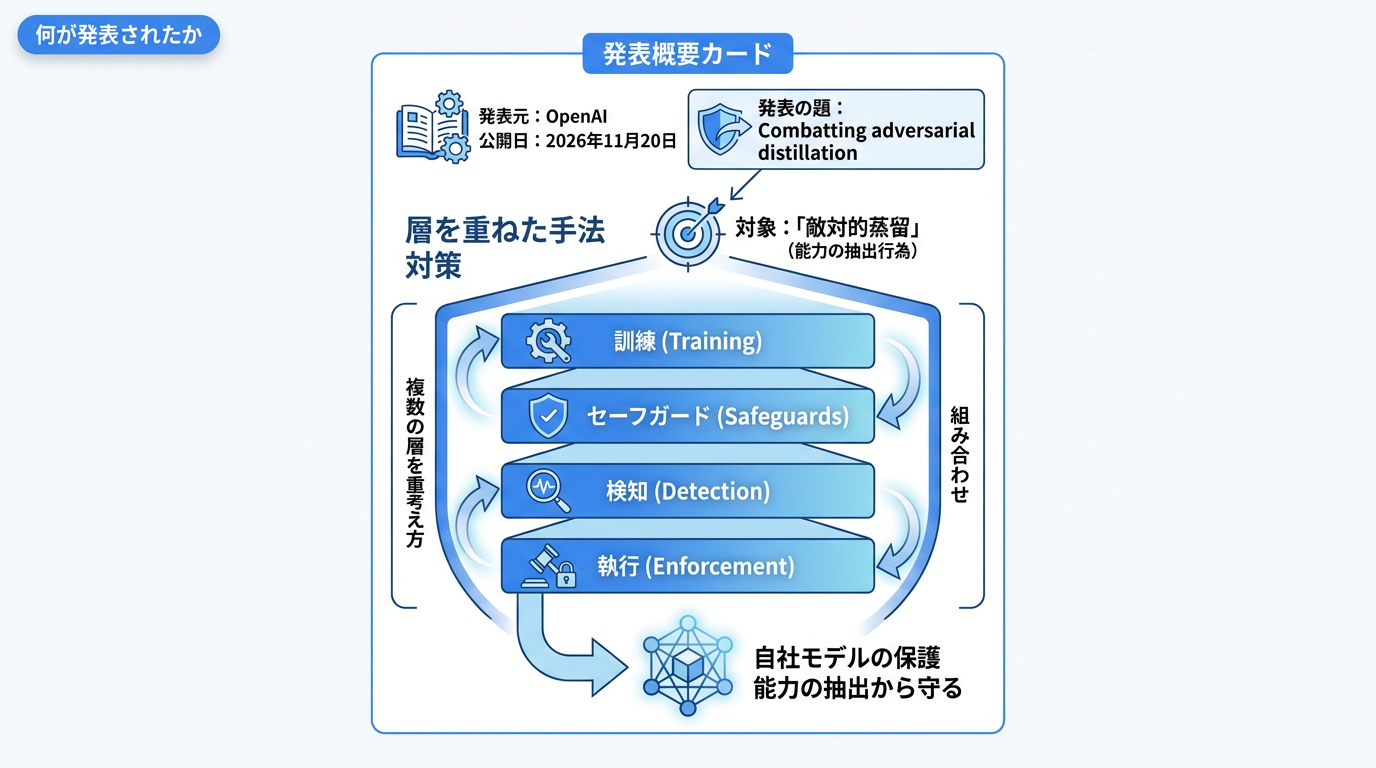
OpenAI は2026年11月20日、Combatting adversarial distillation と題した文書を公開した。発表の要旨によると、同社は敵対的蒸留に「層を重ねた手法」で対処する。その層は、モデルの訓練、セーフガード、検知、執行の4つである。目的は能力の抽出から自社モデルを守ることだと説明している。
protect against capability extraction
— OpenAI「Combatting adversarial distillation」
発表から読み取れる事実は次のとおりだ。
- 発表元は OpenAI、公開日は2026年11月20日
- 対象は「敵対的蒸留」と呼ばれる能力の抽出行為
- 対策は訓練、セーフガード、検知、執行の4つの組み合わせ
- 単独の対策ではなく、複数の層を重ねる考え方を採る
ここで言う能力の抽出は、モデルの中身を直接盗み出す行為とは違う。出力を大量に集め、その振る舞いを別のモデルに写し取る行為を指すと編集部は読んでいる。入口は通常の利用と同じ API やチャットの画面だ。そのため、正当な利用との見分けが難しい。
製品の追加や料金改定の告知は、この要旨には含まれていない。利用者の画面が明日から変わる種類の発表ではない。それでも、OpenAI が自社の守り方を文書にして外へ出した意味は小さくない。
方針を文書にして公開した理由は、要旨には書かれていない。編集部は、抑止と説明の両方を狙ったものと見る。守り方の枠組みを先に示せば、利用者は自分の使い方が対象になるかを事前に考えられる。関係が深いのは、API を自動で大量に呼ぶ開発者と、その出力を保存している企業だ。
注意
本記事は、公式発表の題と公開された要旨にもとづいて書いている。各層の具体的な手法、検知の基準、執行の件数は本記事では扱っていない。詳細は公式の本文で確認してほしい。以下の節では、発表の事実と編集部による解説を分けて記す。
敵対的蒸留とは何か
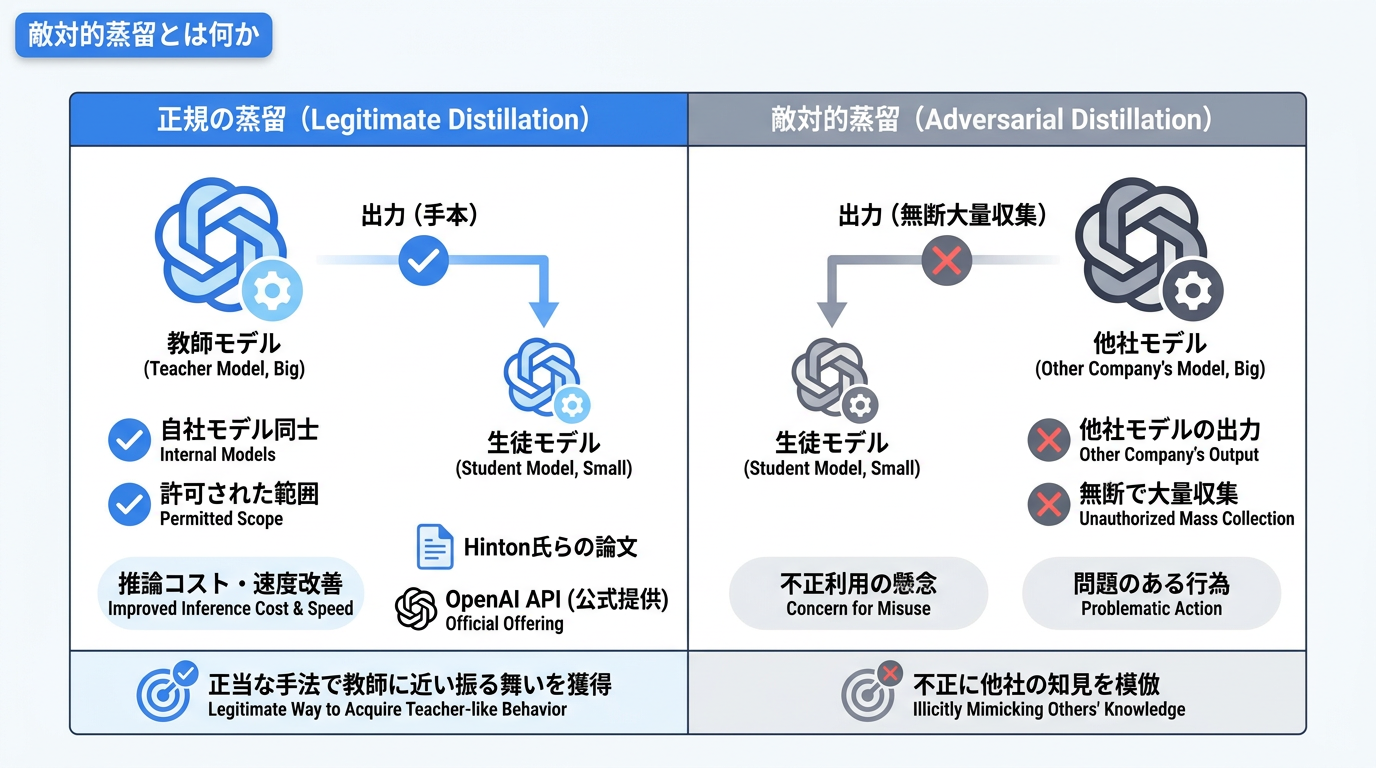
蒸留は、大きなモデルの出力を手本にして小さなモデルを訓練する技術である。考え方は Hinton 氏らの論文 Distilling the Knowledge in a Neural Network で広く知られるようになった。技術そのものは正当で、推論のコストと速度を改善する定番の手法として使われている。
仕組みを簡単に説明する。手本になる大きなモデルを教師、学ぶ側の小さなモデルを生徒と呼ぶ。生徒は、教師が返した答えを正解の代わりに使って学習する。人が正解を付けたデータを大量に用意しなくても、教師に近い振る舞いを得られるのが利点だ。
OpenAI 自身も、API の中で蒸留の仕組みを提供している。公式ドキュメントの蒸留ガイドは、大きなモデルの出力で小さなモデルを微調整する流れを説明している。つまり同社は蒸留を禁じているわけではない。
問題になるのは、提供元の許可なく行う蒸留だ。他社のモデルに大量の質問を投げ、返ってきた出力を集め、競合するモデルの訓練に使う。今回の発表が「敵対的」と呼ぶのは、この種の抽出だと編集部は読んでいる。
| 観点 | 正規の蒸留 | 敵対的蒸留 |
|---|---|---|
| 手本にするモデル | 自社で利用を許された範囲のモデル | 他社が提供するモデル |
| 提供元の許可 | あり(規約と機能の範囲内) | なし(規約に反する) |
| 出力の集め方 | 提供元の用意した機能を使う | 大量の自動呼び出しで収集する |
| 作るモデル | 提供元の基盤の上で動く派生モデル | 提供元と競合する別のモデル |
| 提供元の対応 | 機能として支援 | 検知と執行の対象 |
この表の右列は、各社の規約から編集部が整理した一般的な区分である。OpenAI が今回の文書で示した定義とは細部が異なる場合がある。
表を上から読むと、違いは3つに集約できる。誰のモデルを手本にするか、許可があるか、何を作るかである。出力の集め方は、その結果として変わる。正規の蒸留は提供元の機能の中で完結するので、提供元から見て流れが把握できる。敵対的蒸留は通常の利用を装って出力を集めるため、検知の対象になる。
この区分が関係するのは、モデルを自社で訓練する開発者だけではない。生成 AI の出力を社内データとして蓄積している企業も、のちの用途によっては同じ問いに向き合う。
編集部の視点
蒸留という言葉だけで身構える必要はない。線を引くのは技術ではなく、許可の有無と作るモデルの用途だ。自社の取り組みがどちら側にあるかは、利用規約の文言で判断できる。
できること・特徴
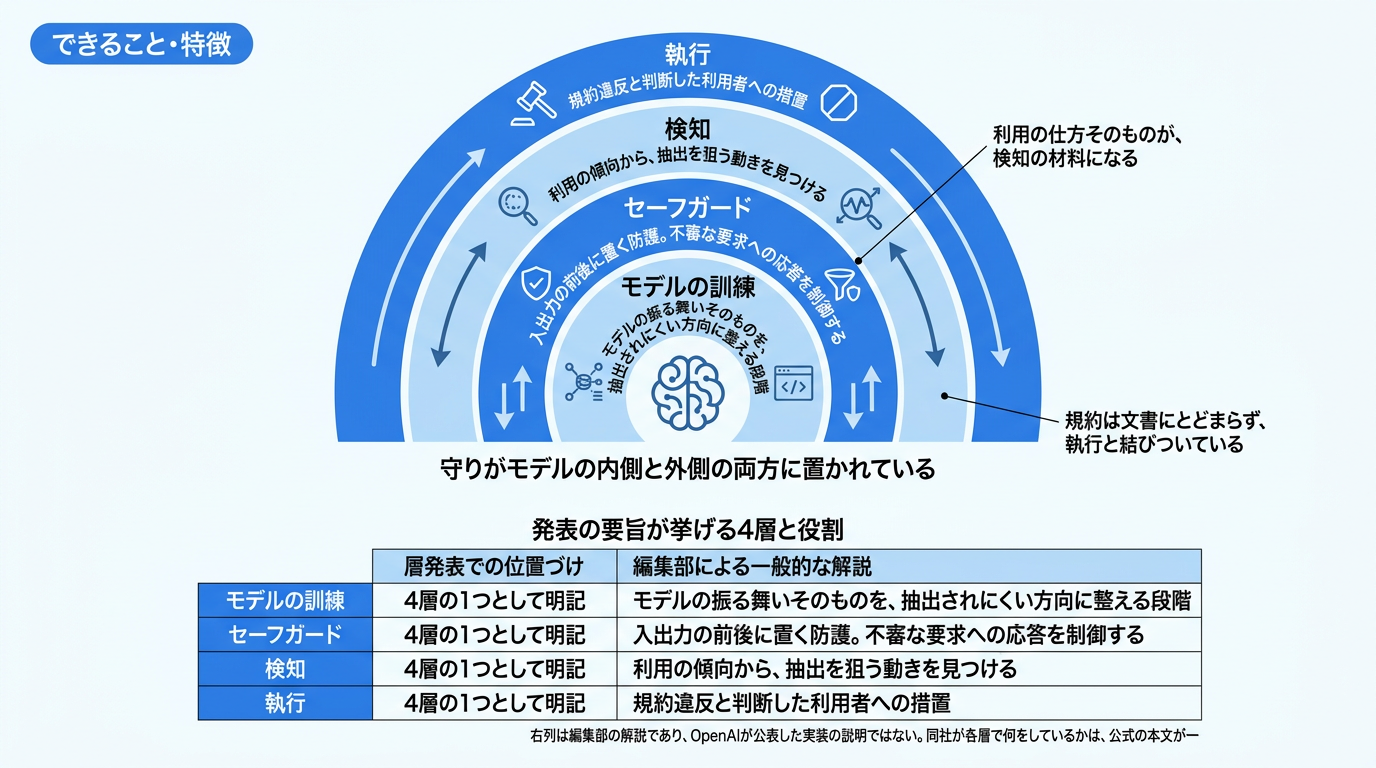
発表の要旨が挙げる層は4つである。OpenAI はこれらを組み合わせて能力の抽出を防ぐと述べている。各層の役割を、編集部の一般的な解説とあわせて整理した。
| 層 | 発表での位置づけ | 編集部による一般的な解説 |
|---|---|---|
| モデルの訓練 | 4層の1つとして明記 | モデルの振る舞いそのものを、抽出されにくい方向に整える段階 |
| セーフガード | 4層の1つとして明記 | 入出力の前後に置く防護。不審な要求への応答を制御する |
| 検知 | 4層の1つとして明記 | 利用の傾向から、抽出を狙う動きを見つける |
| 執行 | 4層の1つとして明記 | 規約違反と判断した利用者への措置 |
右列は編集部の解説であり、OpenAI が公表した実装の説明ではない。同社が各層で何をしているかは、公式の本文が一次情報になる。
4つの層は、働く時点が異なる。訓練はモデルを公開する前の段階にあたる。セーフガードは要求を受けて応答を返すその場で働く。検知は利用が積み重なったあとに傾向を見る。執行は違反と判断したあとの措置である。時間の流れに沿って守りが並んでいると読める。
この発表の特徴は、対策を1つに絞らなかった点にあると編集部は見る。検知だけに頼ると、見逃した分はそのまま流出する。執行だけでは、被害が出たあとの対応になる。訓練の段階から守りを組み込み、後段で検知と執行を重ねる構えは、セキュリティ分野の多層防御と同じ発想だ。
なぜ層を重ねるのか。抽出を狙う側は、1つの対策に合わせて手口を変えられるからだと編集部は考える。呼び出しを小分けにすれば、量だけを見る仕組みはすり抜けられる。別の層が残っていれば、そこで止まる見込みが生まれる。
特徴を読者の立場から言い換えると、次の3点になる。
- 守りがモデルの内側と外側の両方に置かれている
- 利用の仕方そのものが、検知の材料になる
- 規約は文書にとどまらず、執行と結びついている
編集部の視点
4層のうち、一般の利用者に関わるのは検知と執行だと考える。訓練とセーフガードはモデル側の話で、利用者が意識する場面は少ない。自社の呼び出し方が外からどう見えるかを点検しておきたい。
使い方・提供条件・料金
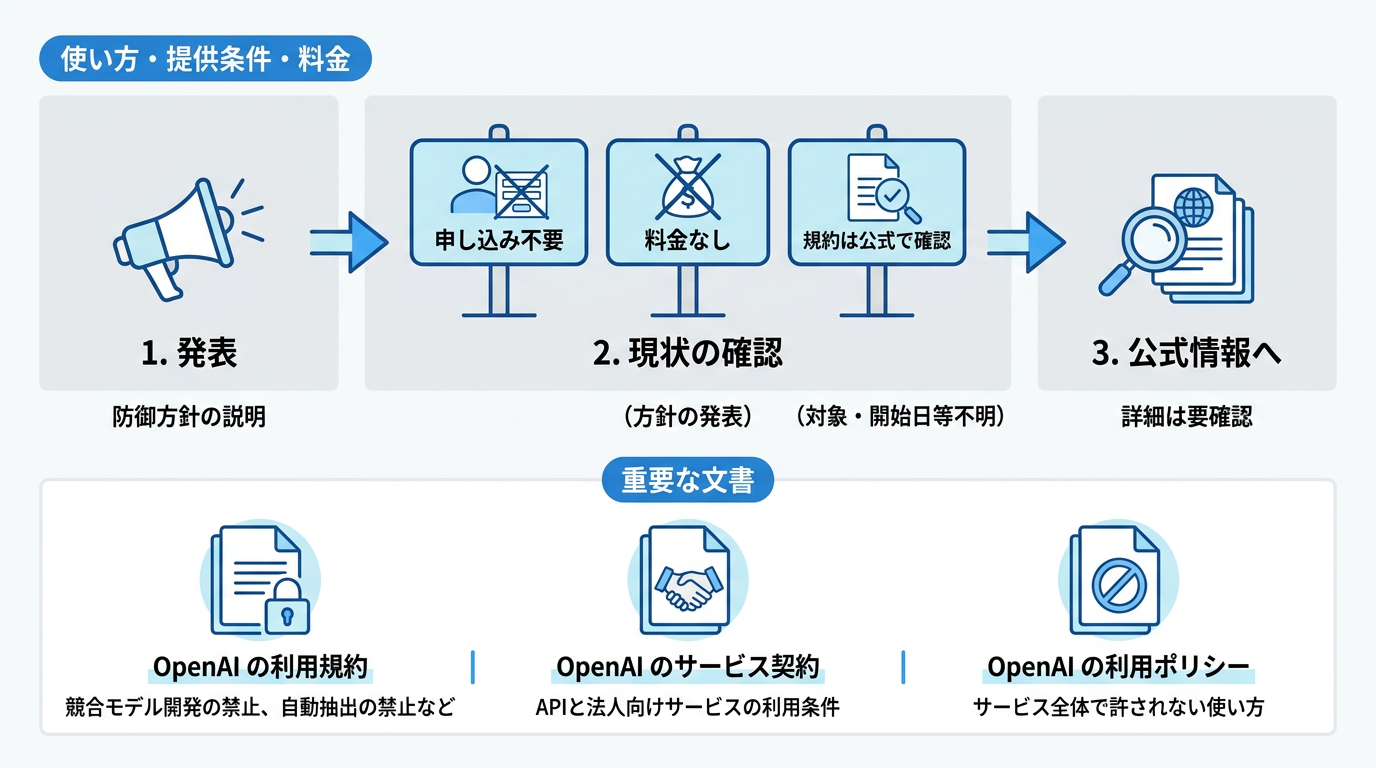
今回の発表は防御方針の説明であり、利用者が申し込む機能ではない。発表の要旨に、料金や提供プランの記載はない。対象となるモデルの範囲や適用の開始日も、要旨からは読み取れない。これらは公式で確認してほしい。
利用者が守るべき条件は、既存の規約に書かれている。執筆時点で確認すべき文書は次の3つだ。
- OpenAI の利用規約。出力を使って OpenAI と競合するモデルを開発することを禁じている
- OpenAI のサービス契約。API と法人向けサービスの利用条件を定める
- OpenAI の利用ポリシー。サービス全体で許されない使い方を示す
利用規約は、データや出力を自動的に、またはプログラムで抽出する行為も禁止事項に挙げている。今回の発表は、こうした規約を技術と運用で裏打ちするものと位置づけられる。
規約が先にあり、技術があとから追いつく順序には理由がある。禁止を文書に書くだけでは、違反を見つける手段がない。検知と執行の層が加わると、規約は実際に効力を持つ取り決めになる。API を契約している企業は、規約を読み飛ばしてよい定型文として扱えなくなる。
正規に蒸留を行いたい場合は、OpenAI が API で提供する蒸留の機能を使う。その料金は、利用するモデルと微調整の価格に従う。金額は改定されるため、公式の料金ページで確認するのが確実だ。現行モデルの位置づけは、GPT-6.2 Astra・Sol の解説記事にまとめている。
読む順番にも目安がある。API と法人向けサービスを契約している企業は、サービス契約から確かめるとよい。利用ポリシーは、契約の形を問わず目を通しておきたい文書だ。3つを並べて読むと、禁止事項がどの文書に書かれているかを社内で共有しやすい。
注意
規約の文言は改定される。本記事の記述は執筆時点の内容にもとづく。契約や開発の判断に使うときは、リンク先の最新版を自分の目で読んでほしい。法人契約では、個別の合意が標準の規約に優先する場合がある。
競合・既存サービスとの比較
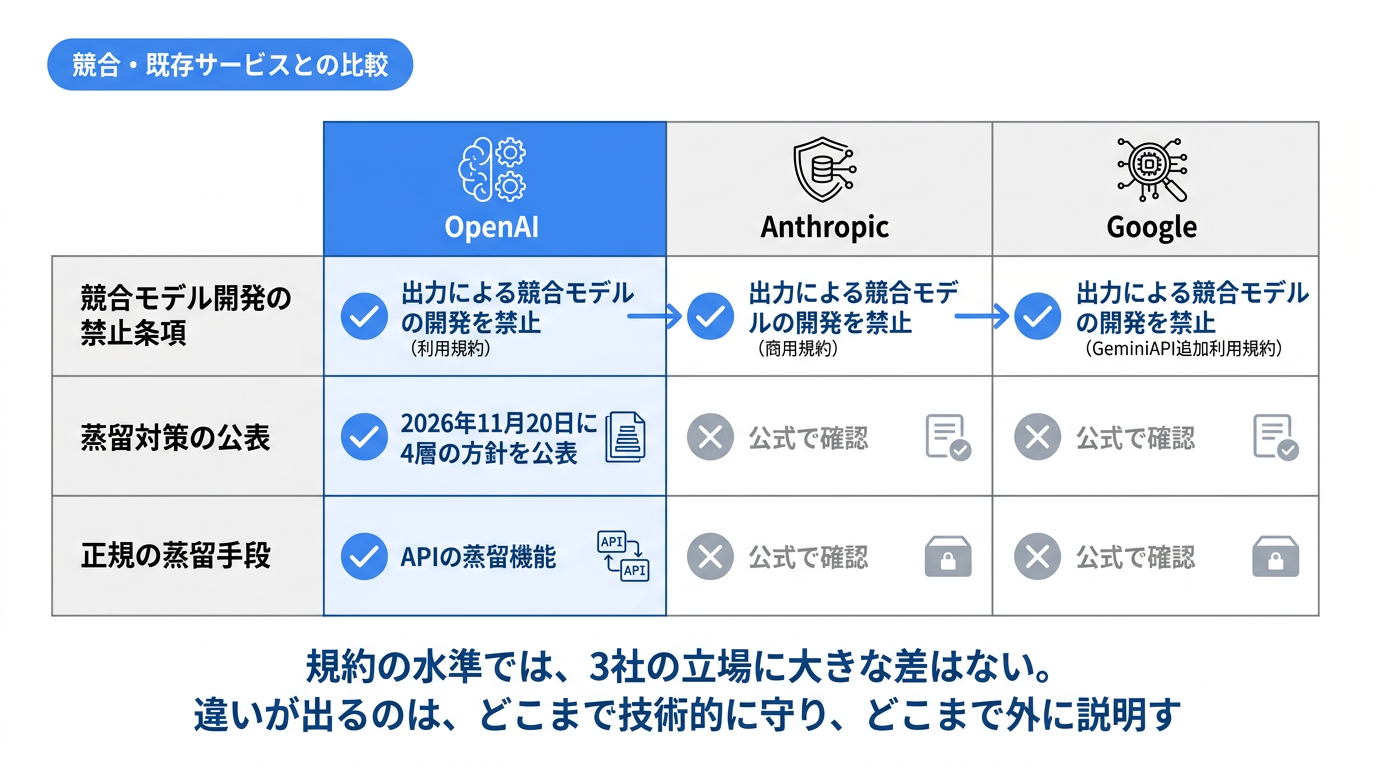
出力を使った競合モデルの開発を禁じる条項は、OpenAI だけのものではない。主要な提供元は、いずれも規約で同じ趣旨の制限を置いている。
| 提供元 | 競合モデル開発に関する規約 | 蒸留対策の公表 | 正規の手段 |
|---|---|---|---|
| OpenAI | 出力による競合モデルの開発を禁止(利用規約) | 2026年11月20日に4層の方針を公表 | API の蒸留機能 |
| Anthropic | 競合する製品の構築と競合 AI モデルの訓練を禁止(商用規約) | 公式で確認 | 公式で確認 |
| サービスと競合するモデルの開発を禁止(Gemini API 追加利用規約) | 公式で確認 | 公式で確認 |
規約の水準では、3社の立場に大きな差はない。違いが出るのは、どこまで技術的に守り、どこまで外に説明するかだ。OpenAI は今回、訓練から執行までを1つの枠組みとして示した。
表の「公式で確認」は、対策が無いという意味ではない。本記事の取材範囲で、公表の有無を確かめていないという意味である。2社の最新の方針は、Anthropic の公式サイトと Google AI for Developers で確認できる。
複数の提供元を併用する企業には、この横並びが効いてくる。あるモデルの出力で、その提供元と競合するモデルを作る計画は、3社のどこが相手でも規約に触れる。提供元を替えれば済む話ではない。
既存の対策と比べたときの位置づけも整理しておく。
| 対策の種類 | 従来の一般的な対応 | 今回の発表の枠組み |
|---|---|---|
| 規約による禁止 | 文書で禁止を明記 | 執行の層として運用と接続 |
| 利用量の制限 | レート制限で大量取得を抑える | 検知の層と組み合わせる |
| モデル側の防御 | 公表例は限られる | 訓練の層として明記 |
| 全体の設計 | 個別の対策の積み上げ | 4層を重ねる方針として提示 |
左から2列目は、業界の一般的な対応を編集部がまとめたものである。各社のモデルの性能や料金の違いは、DeepSeek・Grok・ChatGPT・Gemini・Meta AI の比較記事で扱っている。
2つ目の表で目を引くのは、モデル側の防御の行だ。規約やレート制限は、モデルの外側に置く対策である。訓練の層は、モデルの内側に守りを持たせる考え方を示している。具体的な手法は要旨に書かれていないため、公式の本文と続報で確かめたい。
企業・開発者への影響
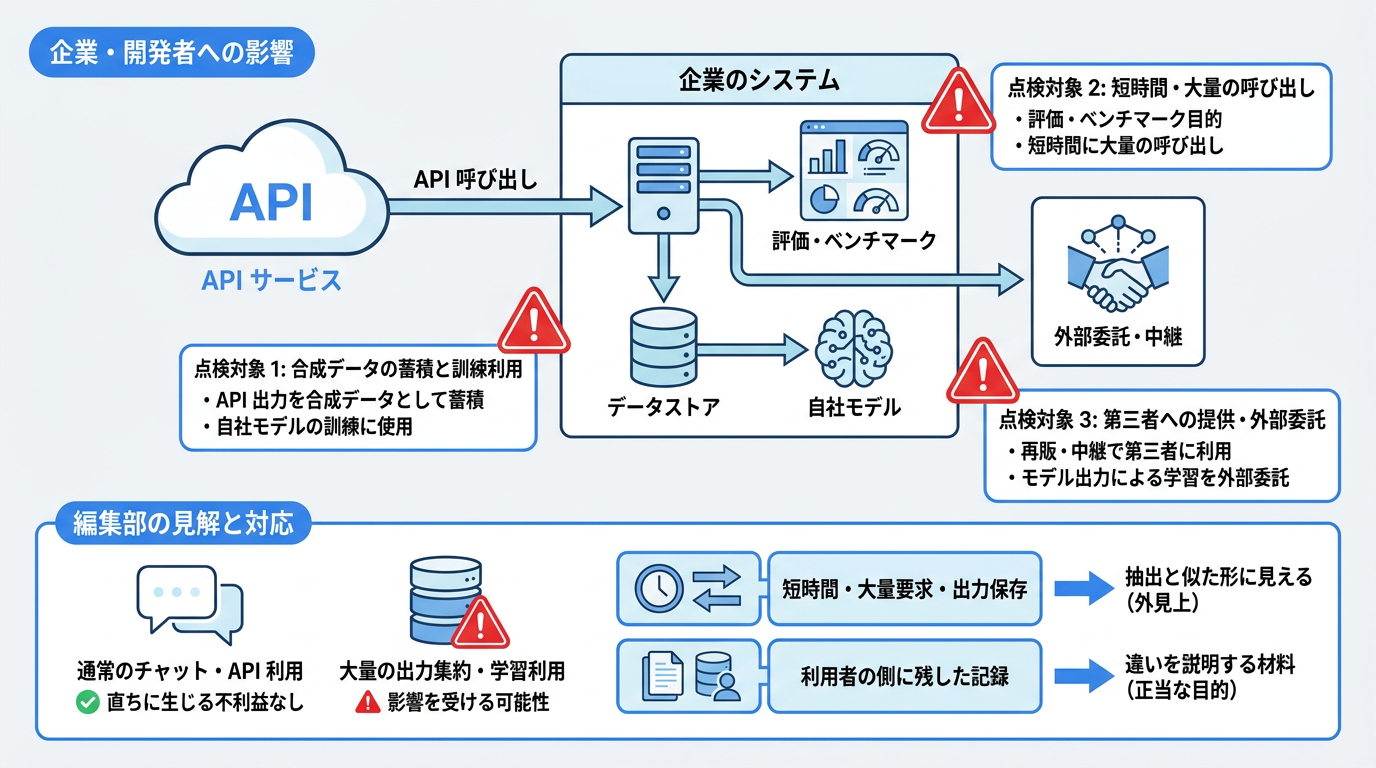
ふつうにチャットや API を使う企業に、今回の発表で直ちに生じる不利益はない。影響を受けるのは、出力を大量に集めて学習に使う場面である。編集部は、次のような利用が点検の対象になると考える。
- API の出力を合成データとして蓄積し、自社モデルの訓練に使っている
- 評価やベンチマークの目的で、短時間に大量の呼び出しを行っている
- 再販や中継のサービスを通じて、第三者に API を使わせている
- 外部の開発会社に、モデルの出力を使った学習を委託している
1つ目と2つ目は、目的が正当でも外からは抽出と似た形に見える。短時間に大量の要求を送り、出力を保存する点が共通するからだ。違いを説明する材料は、利用者の側に残した記録になる。
とくに3つ目と4つ目は、自社が意図しなくても規約違反に巻き込まれる経路になる。中継先の利用者が抽出を行えば、契約上の責任は元の契約者に及ぶ。委託先が何を手本に学習させたかを、発注側が把握していない例も多い。
委託先の選び方は、AIエージェント開発会社の見極め方でも触れた。学習データの出どころを契約書に書かせることを、編集部は勧めている。
編集部の視点
検知が強まれば、正当な大量利用が疑われる場面も出てくると編集部は見る。評価や合成データの生成を行う企業は、目的と件数を記録に残しておくとよい。問い合わせを受けたときに説明できる状態が、いちばんの備えになる。
社内で確認する手順は単純だ。まず、出力を保存している場所と用途を洗い出す。次に、その用途が規約の禁止事項に当たらないかを法務と確かめる。最後に、外部へ API を使わせている経路の利用条件を見直す。導入全体の進め方は、AI導入ロードマップが参考になる。
この点検は、開発部門だけでは終わらない。出力の保存先は開発、用途の判断は法務、中継や委託の契約は調達や事業部門が持っていることが多い。担当をまたいで一覧を1枚作ると、抜けが見つけやすい。
AI Beat 編集部の見解
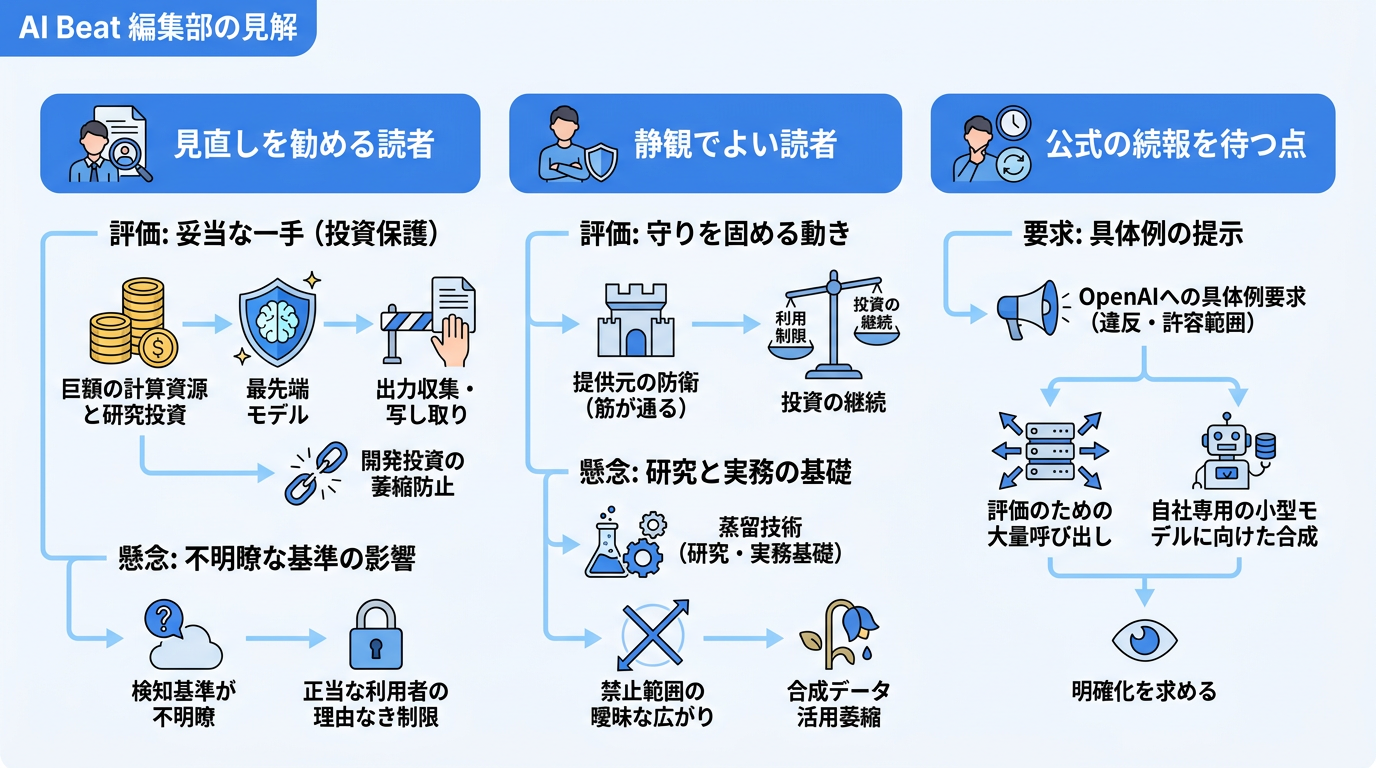
編集部は、この発表を妥当な一手だと評価する。最先端のモデルには巨額の計算資源と研究が注ぎ込まれている。その成果が出力の収集だけで写し取られるなら、開発に投資する理由が弱まる。守りを固める動きは、提供元として筋が通っている。
一方で、手放しでは評価しない。検知の基準が外から見えないままだと、正当な利用者が理由の分からない制限を受けるおそれがある。蒸留は研究と実務の基礎技術だ。禁止の範囲が曖昧に広がれば、合成データの活用そのものが萎縮する。OpenAI には、何が違反で何が許されるかを具体例で示すことを求めたい。
具体例として示してほしいのは、評価のための大量呼び出しと、自社専用の小型モデルに向けた合成データの扱いだ。どちらも現場でよく行われ、線引きに迷いやすい。
読者ごとの判断は次のとおりである。
| 読者 | 編集部の助言 |
|---|---|
| チャットや API を業務でふつうに使う企業 | 対応は不要。規約の改定通知だけ追う |
| 出力を学習データに使っている開発者 | いま規約を読み直す。用途が競合モデルに当たらないか確かめる |
| API を中継、再販している事業者 | 利用者の条件と監視の仕組みを見直す |
| 他社モデルの出力で自社の汎用モデルを作りたい企業 | 勧めない。規約に反し、検知と執行の対象になる |
待つべきものは2つある。1つは、検知と執行の基準についての追加の説明だ。もう1つは、誤って制限された場合の異議申し立ての手順である。この2点が示されるまで、大規模な合成データの計画は規約の確認を済ませてから進めるのがよい。
よくある質問
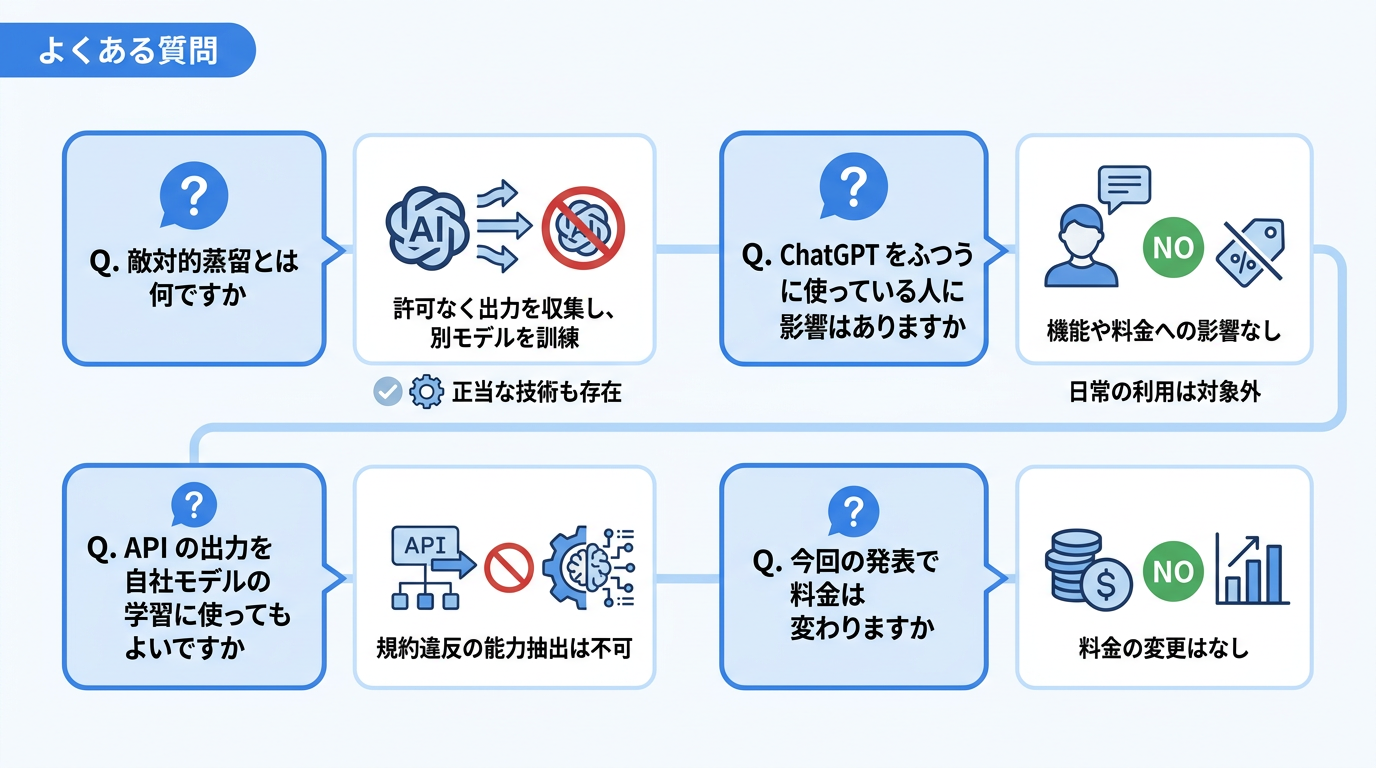
この節で扱う問いは次の7つである。
- 敵対的蒸留の意味
- 一般の利用者への影響
- 出力を学習に使うことの可否
- 料金の変更の有無
- 他社の対応
- 評価目的の大量呼び出しの扱い
- 正規の蒸留の始め方
Q. 敵対的蒸留とは何ですか
提供元の許可なく、モデルの出力を集めて別のモデルの訓練に使う行為を指す。技術としての蒸留は正当なもので、OpenAI も API で機能を提供している。問題になるのは、規約に反して能力を抽出する使い方である。
Q. ChatGPT をふつうに使っている人に影響はありますか
発表の要旨に、一般の利用者の機能や料金を変える記述はない。チャットで調べ物や文章作成をする使い方は、抽出とは性質が異なる。編集部は、日常の利用への影響は小さいと見ている。
Q. API の出力を自社モデルの学習に使ってもよいですか
OpenAI の利用規約は、出力を使って同社と競合するモデルを開発することを禁じている。OpenAI が提供する蒸留の機能を使い、その範囲で派生モデルを作ることは認められている。自社の用途がどちらに当たるかは、規約の最新版と契約内容で確認してほしい。
Q. 今回の発表で料金は変わりますか
発表の要旨に料金の記載はない。今回の文書は防御の方針を説明するもので、価格改定の告知ではない。最新の料金は公式の料金ページで確認できる。
Q. 他社も同じ対策をしていますか
Anthropic と Google も、規約で競合モデルの開発を禁じている。技術的な対策をどこまで公表しているかは会社ごとに異なる。各社の最新の方針は、それぞれの公式サイトが一次情報になる。
Q. 評価のために API を大量に呼ぶと違反になりますか
発表の要旨に、検知の基準や件数の目安は書かれていない。利用規約が禁じているのは、競合モデルの開発と、出力の自動的な抽出である。評価が目的であれば、その目的と件数を記録に残しておくことを編集部は勧める。判断に迷う規模なら、契約の窓口に事前に確かめるのが確実だ。
Q. 正規に蒸留を行うにはどうすればよいですか
OpenAI の公式ドキュメントにある蒸留ガイドの流れに従う。大きなモデルの出力を使い、小さなモデルを微調整する手順が説明されている。料金は利用するモデルと微調整の価格に従うため、公式の料金ページで確認してほしい。
まとめ
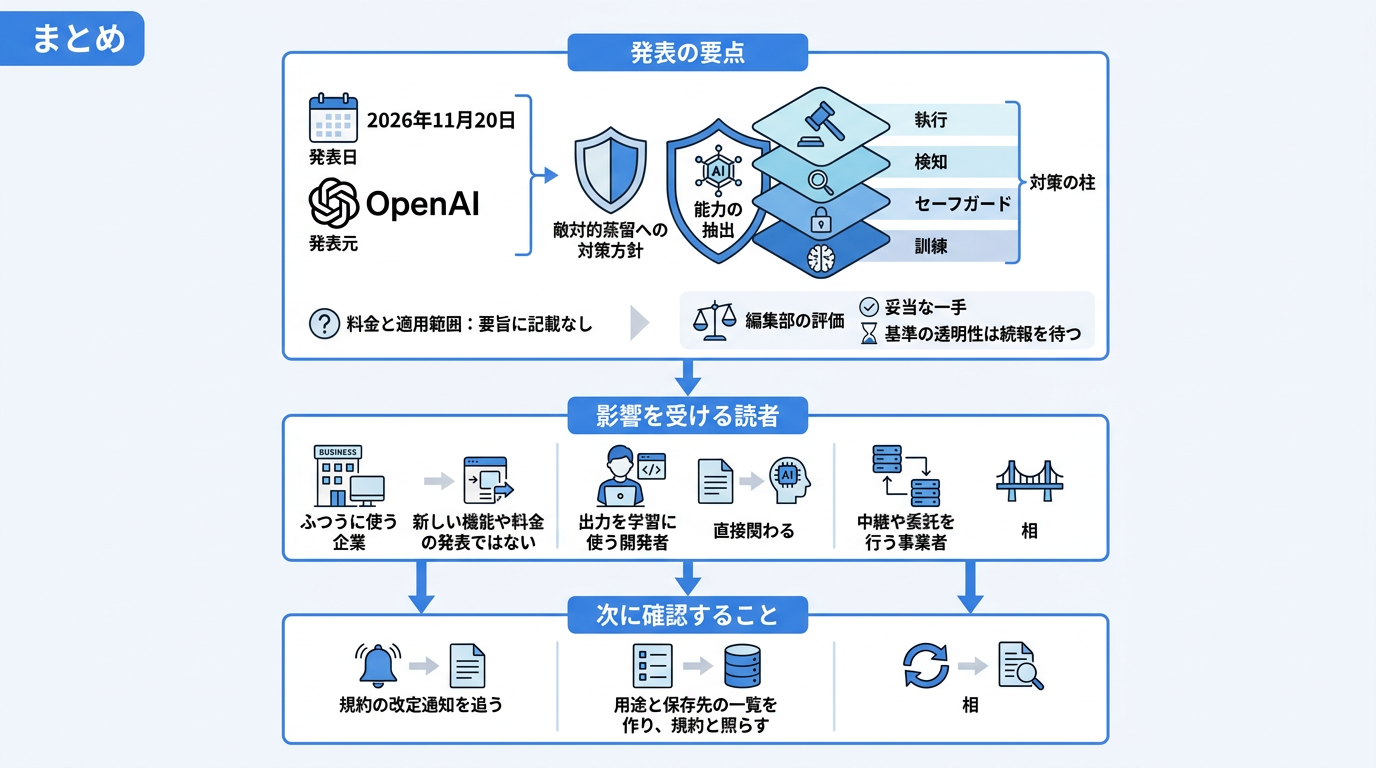
OpenAI は2026年11月20日、敵対的蒸留への対策方針を公表した。訓練、セーフガード、検知、執行の4層を重ね、能力の抽出から自社モデルを守るという内容である。新しい機能や料金の発表ではないが、出力を学習に使う企業には直接関わる。
| 項目 | 内容 |
|---|---|
| 発表日 | 2026年11月20日 |
| 発表元 | OpenAI |
| 対策の柱 | 訓練、セーフガード、検知、執行 |
| 料金と適用範囲 | 要旨に記載なし。公式で確認 |
| 編集部の評価 | 妥当な一手。基準の透明性は続報を待つ |
読者が次に取る行動は、立場によって変わる。ふつうに使う企業は、規約の改定通知を追えば足りる。出力を学習に使う開発者は、用途と保存先の一覧を作り、規約と照らす。中継や委託を行う事業者は、相手先との契約に学習データの出どころを書き込む。
編集部は、守りの強化そのものを支持する。そのうえで、検知の基準と異議申し立ての手順が示されるかを引き続き取材する。続報があれば本記事を更新する。
持ち帰り
- 蒸留は正当な技術。問われるのは許可の有無と用途
- 出力を学習に使うなら、利用規約の禁止事項をいま読み直す
- 中継先と委託先の使い方まで、契約で押さえておく
- 検知の基準と異議申し立ての手順は、公式の続報を待つ
最終更新: 2026年11月


